10 listopada 2026
Integracja to nie tylko API. Co decyduje o niezawodnym przepływie danych między systemami?
Samo połączenie dwóch systemów przez API nie gwarantuje jeszcze, że proces będzie działał poprawnie. O jakości integracji decyduje przede wszystkim to, co wydarzy się przy błędnych danych, timeoutach, ponowieniach operacji i zmianach po stronie systemów. W artykule pokazujemy, jakie mechanizmy pozwalają taki przepływ monitorować, diagnozować i bezpiecznie odtwarzać.
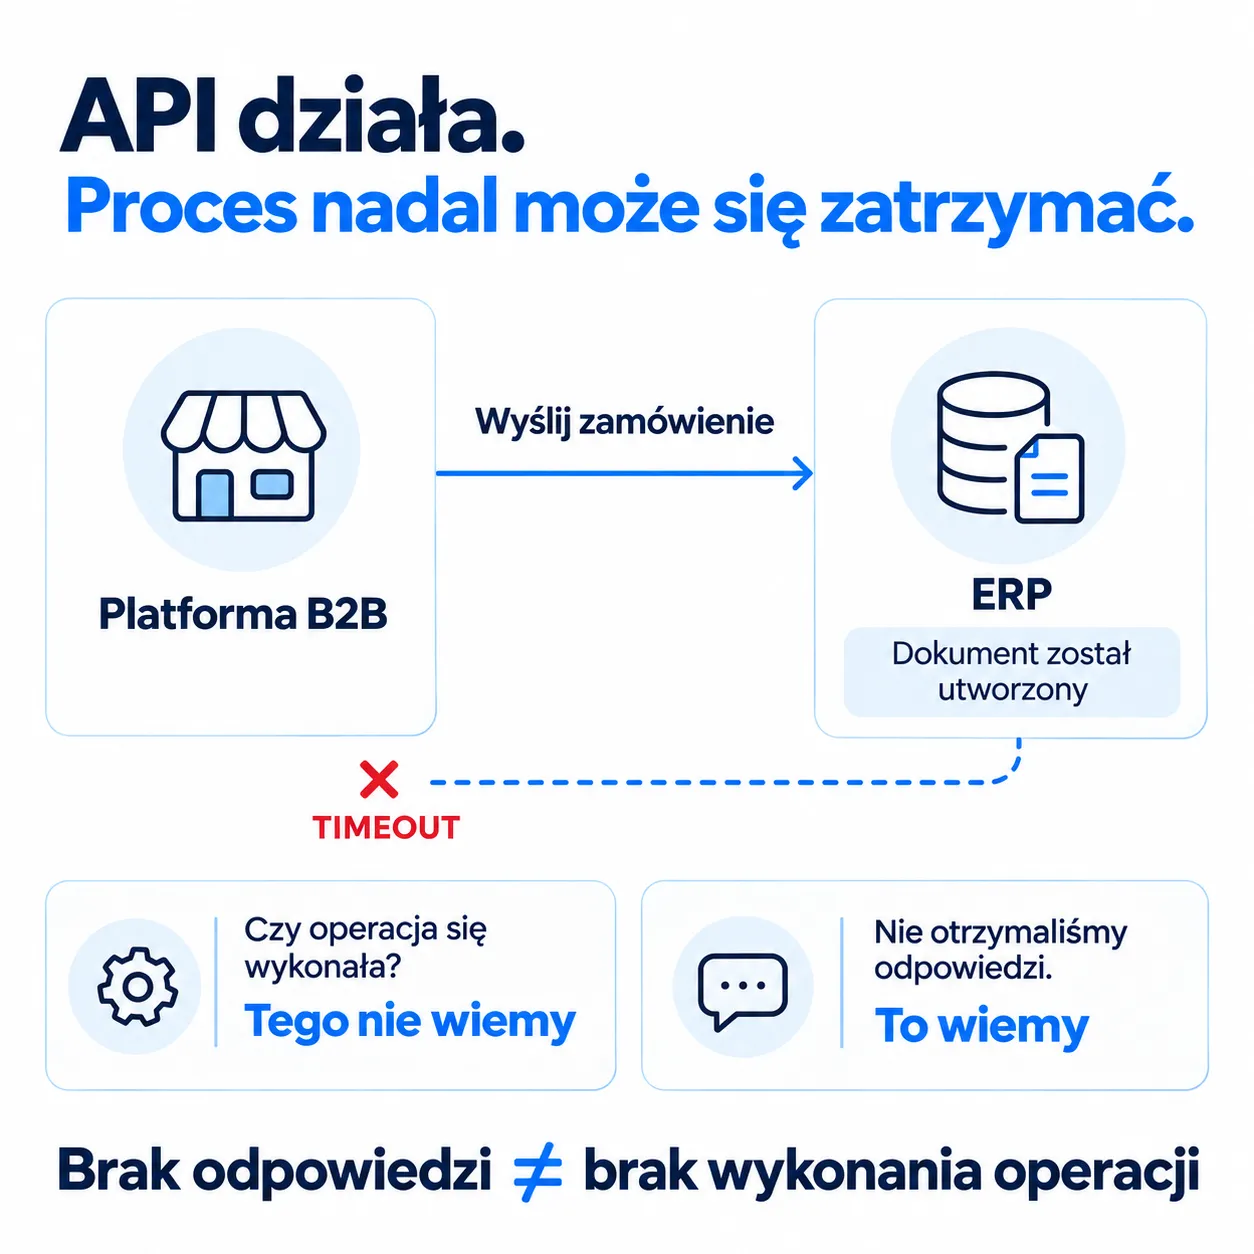
Klient składa zamówienie na platformie B2B.
System przekazuje dane do ERP. ERP rozpoczyna przetwarzanie dokumentu, ale platforma nie otrzymuje odpowiedzi w oczekiwanym czasie.
Pojawia się timeout.
Co powinno wydarzyć się dalej?
Najprostsza odpowiedź brzmi: wysłać zamówienie ponownie.
Problem w tym, że brak odpowiedzi nie oznacza jeszcze, że pierwsza operacja się nie wykonała.
ERP mógł poprawnie utworzyć dokument, a przerwaniu uległa dopiero komunikacja zwrotna. Ponowienie tej samej operacji może więc zakończyć się utworzeniem drugiego zamówienia.
Techniczne połączenie między systemami może działać poprawnie. Dane zostały przesłane, endpoint był dostępny podczas testów, a komunikacja w standardowym scenariuszu przebiega bez problemu.
Mimo to pojedyncze zakłócenie może doprowadzić do duplikatu dokumentu, błędnej rezerwacji towaru, kolejnej operacji w magazynie albo nieprawidłowej informacji dla klienta.
Właśnie w takich sytuacjach okazuje się, że integracja to znacznie więcej niż możliwość wywołania API.
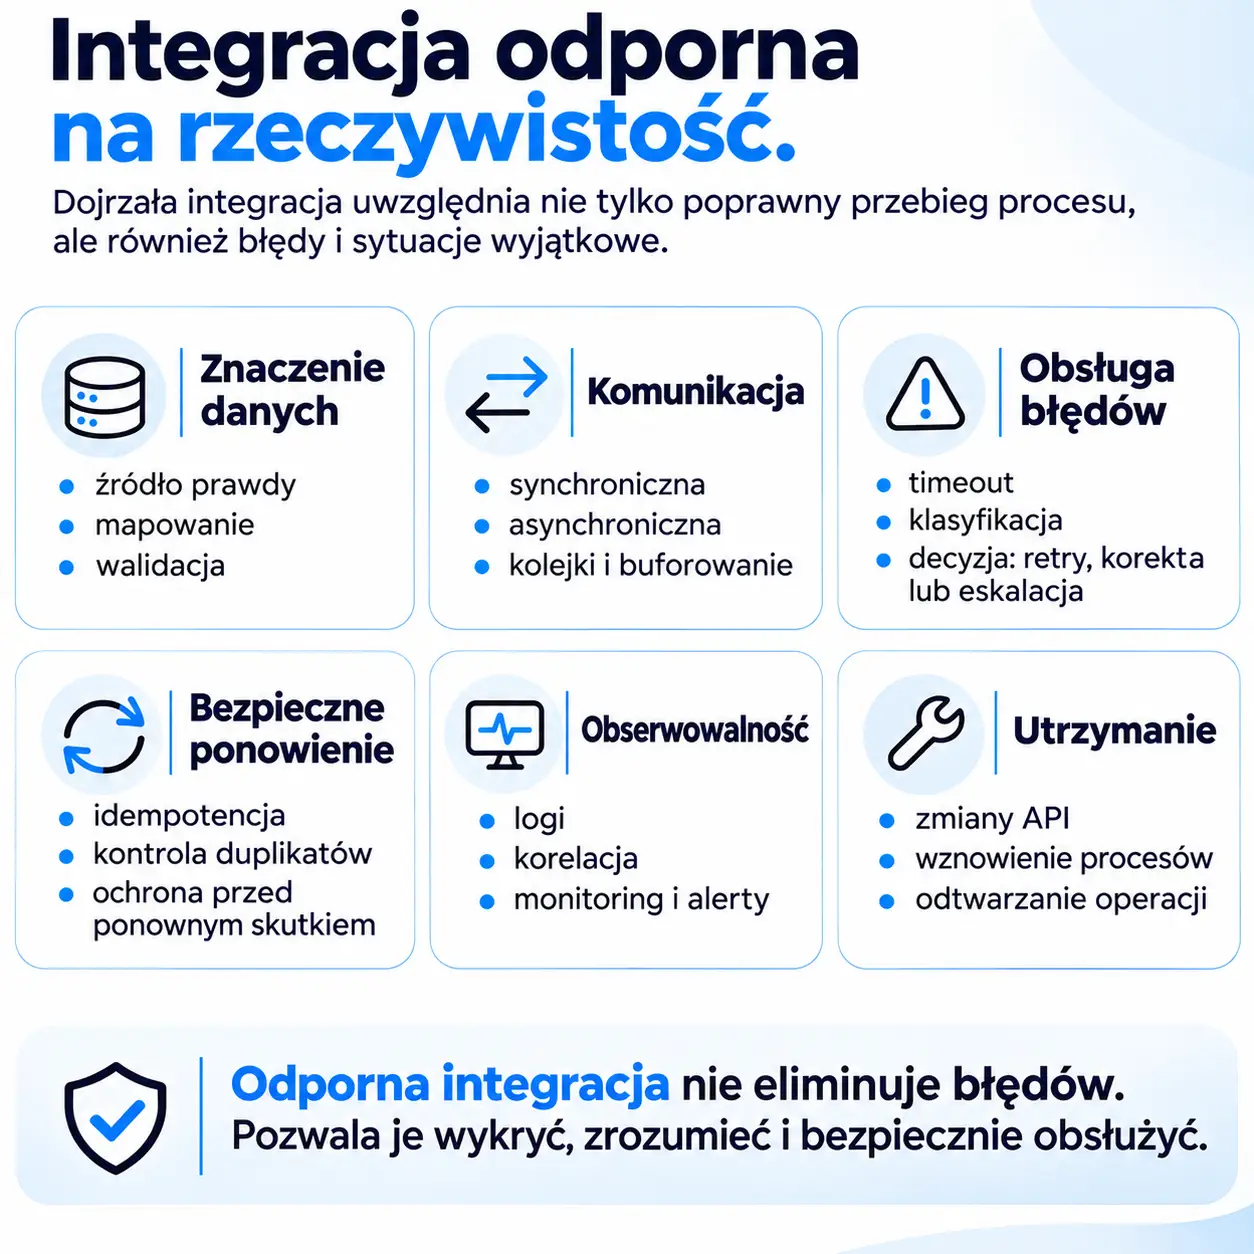
Dojrzała integracja musi określać nie tylko sposób przesłania danych, ale również ich znaczenie, źródło, zachowanie procesu przy błędzie, zasady bezpiecznego ponawiania operacji, sposób śledzenia przepływu oraz możliwość jego odtworzenia.
Dlatego niezawodna integracja nie oznacza integracji, w której nigdy nie występuje błąd.
Oznacza taką, która potrafi błąd wykryć, ograniczyć jego skutki, pokazać miejsce jego wystąpienia i pozwolić bezpiecznie przywrócić dalszy przebieg procesu.
API jest początkiem integracji, a nie jej końcem
Podczas pierwszych testów integracja często wygląda prosto.
Jeden system wysyła przykładowy komunikat. Drugi go odbiera. Dane trafiają do właściwych pól. Odpowiedź wraca z poprawnym statusem.
Połączenie działa.
To ważny etap, ale udany test pokazuje przede wszystkim, że systemy potrafią się ze sobą komunikować w przewidzianym scenariuszu.
Nie odpowiada jeszcze na pytania, które pojawią się w normalnej pracy.
Co stanie się, jeśli system docelowy będzie przez kilka minut niedostępny? Co jeśli odpowiedź przyjdzie po czasie? Co jeśli ten sam komunikat zostanie wysłany dwa razy? Co jeśli brakuje obowiązkowej wartości albo system zewnętrzny odrzuci operację?
Integracja działa pomiędzy systemami o różnej dostępności, własnych regułach przetwarzania i niezależnych cyklach zmian.
API zapewnia kanał komunikacji.
Projekt integracji określa, jak przez ten kanał ma działać rzeczywisty proces biznesowy również wtedy, gdy przebieg nie jest idealny.
Obejmuje to również bezpieczeństwo: kto może wykonać określoną operację, do jakich danych ma dostęp, jak chronione są dane połączeniowe i jakie uprawnienia obowiązują po obu stronach.
Poprawna transmisja nie oznacza jeszcze poprawnych danych
Nie każda wadliwa integracja kończy się błędem technicznym.
Może się zdarzyć, że wszystkie wywołania zakończą się powodzeniem, a proces nadal będzie działał nieprawidłowo.
ERP przekazuje do platformy sprzedażowej status zamówienia oznaczony wartością 3.
Komunikat jest poprawny. Platforma go odbiera i zapisuje.
Problem pojawia się wtedy, gdy w ERP wartość 3 oznacza „przekazane do realizacji”, a system odbiorczy interpretuje ją jako „gotowe do wysyłki”.
Nie ma timeoutu ani błędu serwera. Z technicznego punktu widzenia transmisja zakończyła się sukcesem.
Niepoprawne jest znaczenie danych.
Dla klienta może to oznaczać wyświetlenie błędnego statusu. Dla pracownika - podjęcie decyzji na podstawie informacji, która nie odpowiada rzeczywistemu etapowi procesu.
Dlatego przed uruchomieniem integracji trzeba ustalić nie tylko, jak przesyłamy informacje, ale również co dokładnie oznaczają.
Dla poszczególnych kategorii danych powinno być wiadomo, który system jest źródłem rozstrzygającym. Dotyczy to m.in. kartoteki produktu, ceny, stanu magazynowego, danych klienta, numeru dokumentu czy statusu realizacji.
Trzeba uzgodnić także identyfikatory, mapowanie pól, słowniki, jednostki, formaty i zasady walidacji.
Jeżeli jeden system używa kilogramów, a drugi sztuk, samo prawidłowe przesłanie liczby nie wystarczy.
Jeżeli dwie aplikacje przechowują inne identyfikatory tego samego kontrahenta, trzeba wiedzieć, jak je powiązać.
Jeżeli obowiązkowej wartości brakuje, system powinien wiedzieć, czy operację zatrzymać, uzupełnić według określonej reguły czy przekazać do obsługi.
Integracja nie jest więc wyłącznie transportem danych. Jest również uzgodnieniem ich znaczenia.
Nie każdy proces powinien czekać na odpowiedź
Jeżeli użytkownik musi znać wynik operacji przed wykonaniem kolejnego kroku, system zwykle potrzebuje odpowiedzi od razu.
W innych procesach - np. przy przetwarzaniu dokumentów, aktualizacji danych produktowych czy dużych paczek informacji - komunikat może zostać przyjęty i obsłużony później.
Różnica staje się szczególnie istotna podczas awarii.
Jeżeli cały proces czeka na odpowiedź zewnętrznego systemu, jego niedostępność może zatrzymać użytkownika.
Jeżeli operacja może zostać wykonana później, warto zaprojektować ją tak, aby komunikat poczekał na możliwość przetworzenia.
To w praktyce różnica między komunikacją synchroniczną i asynchroniczną.
Żaden z tych modeli nie jest z definicji lepszy.
Komunikacja asynchroniczna wprowadza dodatkowe wymagania: trzeba kontrolować status, kolejność, opóźnienie i sytuacje, w których komunikatu nie uda się obsłużyć.
Dlatego właściwe pytanie nie brzmi:
„Czy używamy REST, SOAP, pliku czy kolejki?”
Lepiej zapytać:
jak ma zachować się proces, jeśli odpowiedź nie może pojawić się od razu?
Dopiero z tej odpowiedzi powinien wynikać dobór mechanizmu komunikacji.
Nie każdy błąd oznacza to samo
Po nieudanej transmisji naturalna reakcja brzmi: spróbujmy ponownie.
To często właściwe rozwiązanie - ale nie dla każdego błędu.
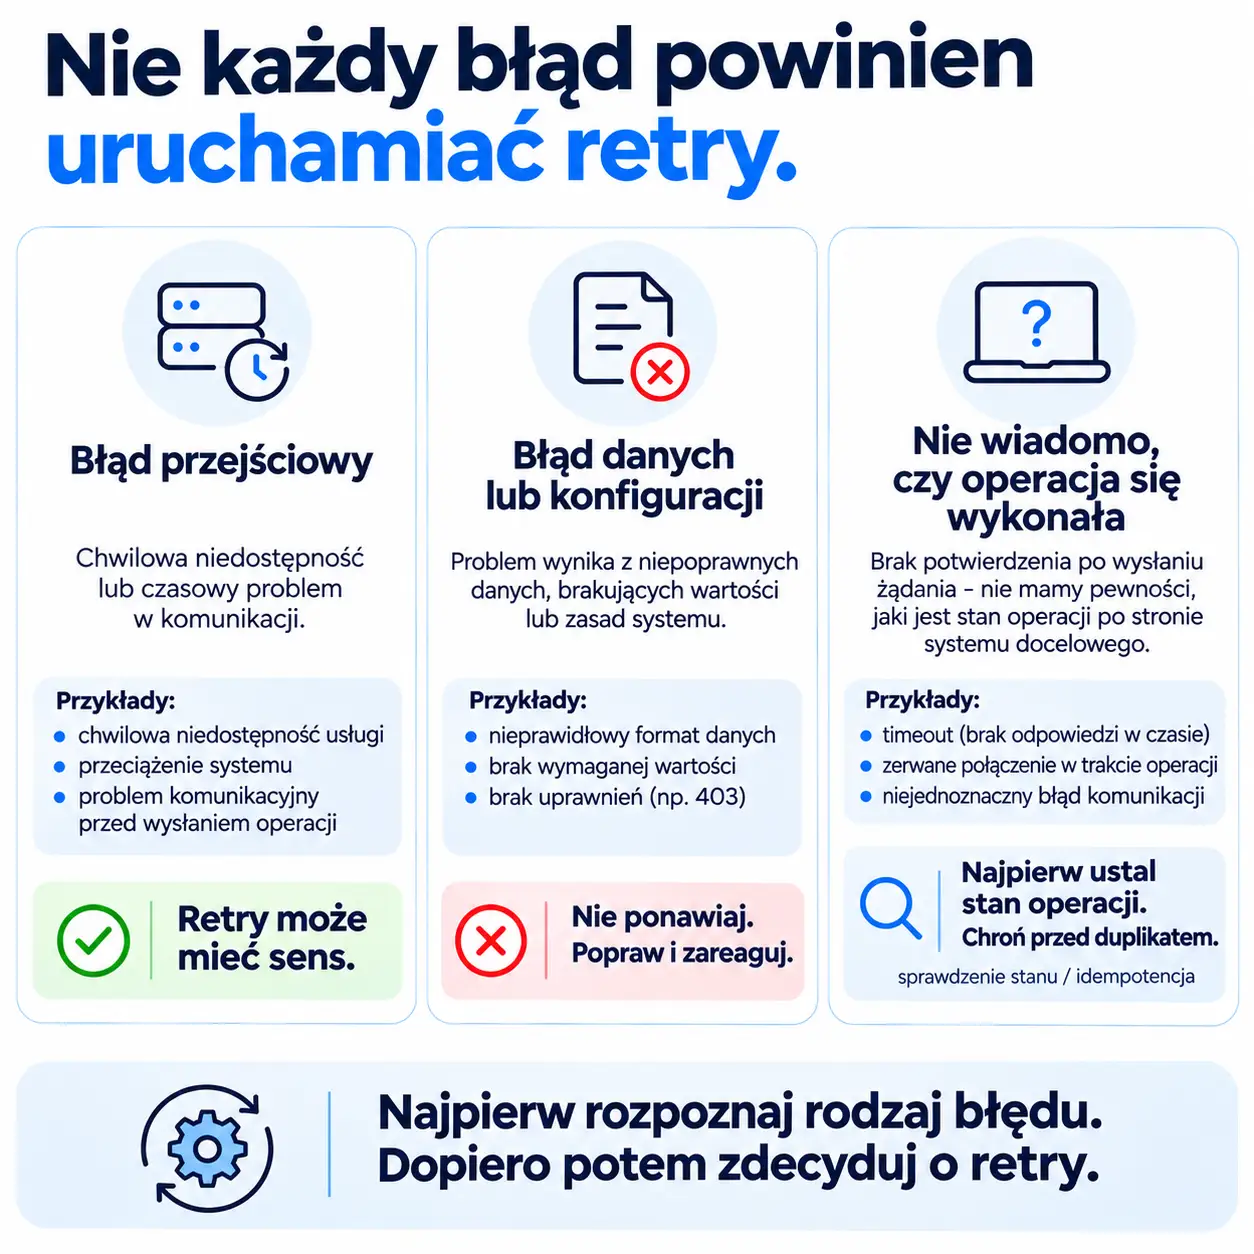
Chwilowa niedostępność usługi albo krótkotrwały problem z siecią mogą ustąpić po kilku sekundach. W takim przypadku ponowienie operacji ma sens.
Inaczej wygląda sytuacja, gdy system odrzuca dokument dlatego, że brakuje wymaganej wartości, użytkownik nie ma odpowiednich uprawnień albo identyfikator produktu nie istnieje.
Dziesięć kolejnych prób wysłania tego samego komunikatu nie naprawi danych.
Jeszcze innym przypadkiem jest timeout po wysłaniu operacji.
Tutaj problem polega na tym, że system wysyłający nie wie, jaki był jej rezultat.
Dlatego trzeba rozróżnić przynajmniej trzy sytuacje:
- błąd przejściowy, po którym operację można ponowić,
- błąd danych lub konfiguracji wymagający poprawy,
- niejednoznaczny rezultat, przy którym najpierw trzeba ustalić, co rzeczywiście wydarzyło się po drugiej stronie.
Od rodzaju błędu zależy dalsze działanie.
Mechanizm retry nie powinien więc być reakcją na każdy problem komunikacyjny. Musi wynikać z tego, co naprawdę oznacza dany błąd i jakie skutki może mieć ponowienie operacji.
Retry trzeba zaprojektować, a nie tylko włączyć
Mechanizm ponawiania nie powinien oznaczać prostego:
„pojawił się błąd - wyślij ponownie”.
Trzeba określić, które błędy można ponawiać, ile prób wykonać, jakie odstępy między nimi zastosować i co powinno wydarzyć się po przekroczeniu limitu.
Jeżeli zewnętrzny system jest przeciążony, natychmiastowe wysyłanie kolejnych żądań może tylko zwiększyć problem.
W innym procesie zbyt długie oczekiwanie może niepotrzebnie blokować pracę użytkownika.
Po wyczerpaniu automatycznych prób operacja również nie może po prostu zniknąć.
Powinna otrzymać stan pozwalający ustalić, że wymaga dalszej obsługi. W systemach opartych na kolejkach może np. trafić do wydzielonej kolejki błędów. W innym rozwiązaniu może otrzymać status wymagający interwencji operatora.
Najważniejsza jest zasada:
nieudana operacja nie powinna stawać się operacją niewidoczną.
Ponowienie operacji nie może tworzyć drugiego zamówienia
Wróćmy do sytuacji z początku artykułu.
Platforma B2B wysłała zamówienie do ERP.
ERP je utworzył, ale odpowiedź nie wróciła.
System wysyłający widzi timeout i ponawia operację.
Jeżeli każda próba zostanie potraktowana jako nowe żądanie, w ERP mogą powstać dwa dokumenty.
Tutaj pojawia się pojęcie idempotencji.
W praktyce oznacza możliwość bezpiecznego ponowienia tej samej operacji bez wykonania jej niepożądanych skutków po raz drugi.
Jednym ze sposobów jest przekazywanie wraz z operacją unikalnego identyfikatora. Jeżeli system docelowy ponownie otrzyma żądanie z tym samym identyfikatorem, może rozpoznać, że operacja została już obsłużona.
Konkretny mechanizm zależy od systemu i procesu.
Istotny jest efekt.
Idempotencja nie jest potrzebna dlatego, że jest popularnym pojęciem architektonicznym.
Chroni przed bardzo konkretnym skutkiem biznesowym: drugim zamówieniem, drugim dokumentem, podwójną płatnością albo ponownym wykonaniem tej samej czynności.
Czasem trzeba najpierw ustalić rzeczywisty stan
Nie w każdym środowisku można zapewnić taki mechanizm po obu stronach integracji.
System zewnętrzny może nie obsługiwać klucza idempotencji albo nie pozwalać na zmianę sposobu tworzenia dokumentu.
Wtedy po niejednoznacznym błędzie potrzebny może być dodatkowy krok.
Zanim operacja zostanie powtórzona, integracja sprawdza, czy rezultat pierwszej próby już istnieje.
W przypadku zamówienia może to oznaczać pytanie do ERP:
czy dokument o określonym identyfikatorze zewnętrznym został już zapisany?
Jeżeli tak - nie tworzymy go ponownie.
Jeżeli nie - można podjąć kolejną próbę.
Takie uzgodnienie stanu zwiększa złożoność procesu, ale w części integracji jest jedynym bezpiecznym sposobem poradzenia sobie z niepewnością po błędzie komunikacji.
Timeout jest informacją o komunikacji. Nie jest jednoznaczną informacją o wyniku operacji biznesowej.
Błąd musi być możliwy do znalezienia i powiązania z konkretną sprawą
Załóżmy, że jedna z transmisji zakończyła się błędem.
Pierwsze pytanie brzmi: czy system to zapisał?
Drugie: czy możemy znaleźć właśnie tę operację?
Sam wpis:
HTTP 500 - Internal Server Error
może być przydatny programiście, ale nie wystarczy do obsługi procesu.
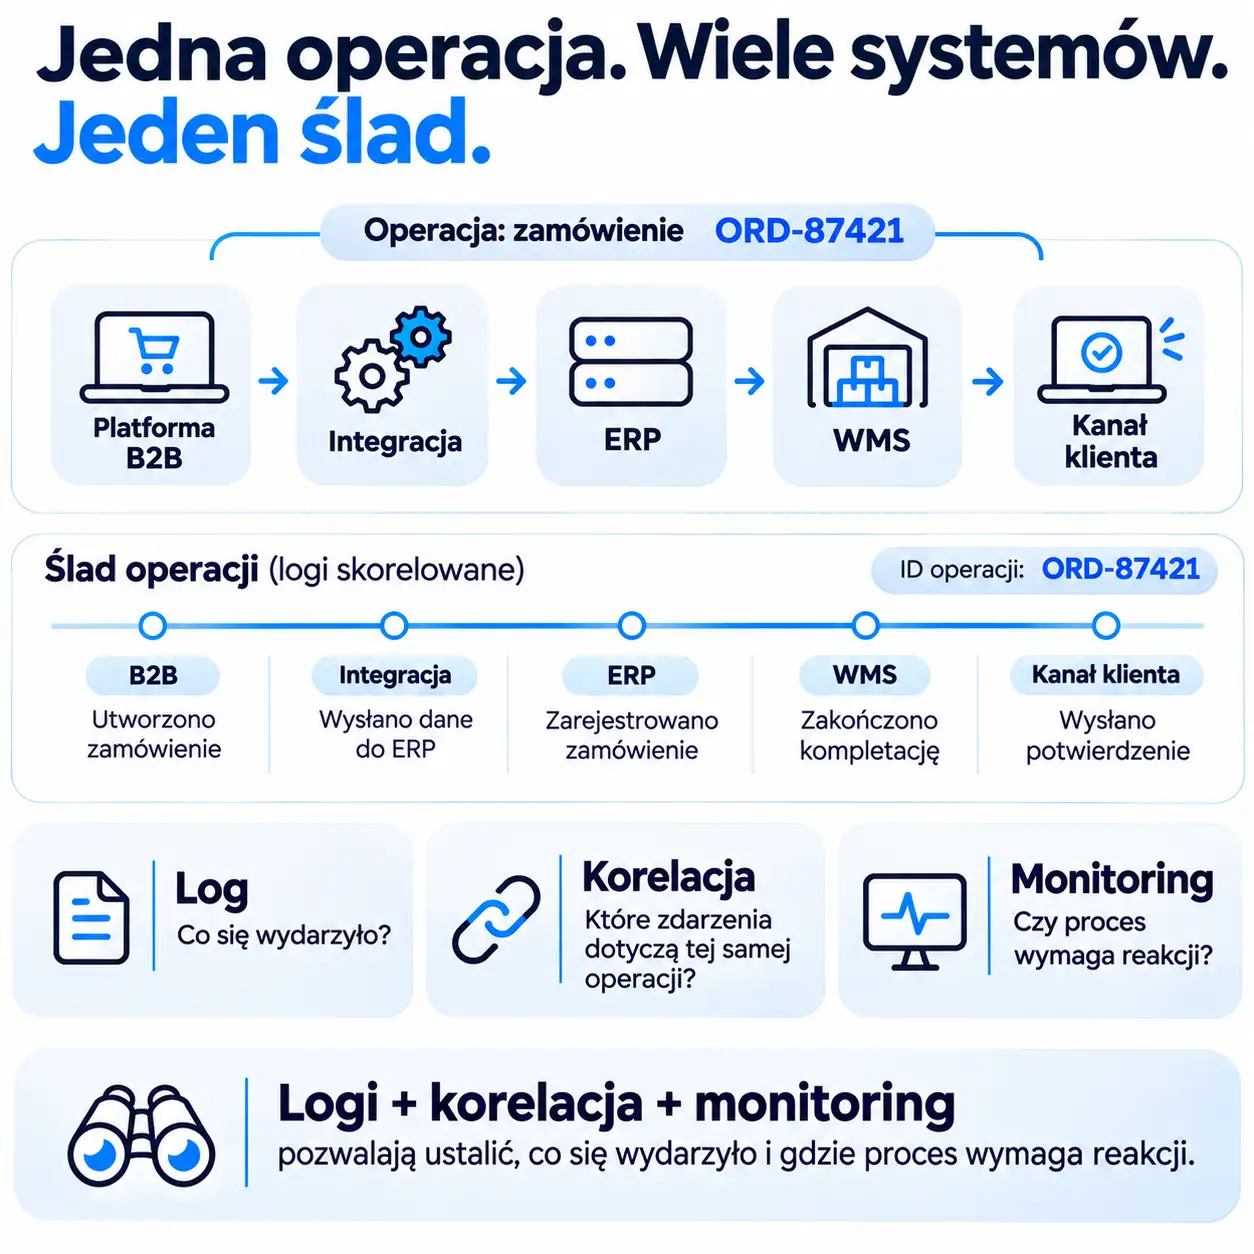
Jeżeli problem dotyczy konkretnego zamówienia, trzeba móc powiązać błąd z jego identyfikatorem, czasem transmisji, systemem źródłowym, kolejnymi próbami i końcowym rezultatem.
W przepływie obejmującym kilka aplikacji potrzebny jest również sposób rozpoznania, że różne wpisy dotyczą tej samej sprawy.
To właśnie rola korelacji.
Nie chodzi o konkretny standard techniczny, lecz o zasadę:
pojedyncza operacja powinna mieć identyfikator pozwalający prześledzić jej drogę przez kolejne elementy procesu.
Dzięki temu podczas diagnozy nie szukamy:
„jakiegoś błędu około 12:30”.
Szukamy konkretnego zamówienia, dokumentu lub komunikatu.
Log i monitoring odpowiadają na inne pytania
Log pozwala sprawdzić:
co się wydarzyło?
Korelacja:
które zdarzenia dotyczą tej samej operacji?
Monitoring powinien odpowiedzieć:
czy dzieje się coś, co wymaga reakcji?
To istotna różnica.
Organizacja może posiadać bardzo szczegółowe logi każdej transmisji, a mimo to dowiedzieć się o awarii dopiero od użytkownika:
„Od dwóch godzin nie pojawiają się nowe zamówienia.”
Dojrzały monitoring powinien pozwalać rozpoznać nietypowy stan wcześniej.
Może to być rosnąca liczba błędów, brak transmisji przez określony czas, narastająca kolejka, brak oczekiwanych potwierdzeń albo operacje pozostające zbyt długo w jednym statusie.
Nie każdy pojedynczy timeout wymaga alarmu.
Jeżeli pierwsza próba się nie udała, ale kolejna zakończyła powodzeniem, alert po każdym błędzie stworzyłby przede wszystkim szum.
Dlatego najważniejsze pytanie brzmi:
czy proces wrócił do prawidłowego stanu, czy nadal wymaga reakcji?
Integrację trzeba testować również przez awarie
Najłatwiejszy test wygląda tak:
wysyłamy poprawny dokument i sprawdzamy, czy pojawił się w drugim systemie.
Taki scenariusz jest potrzebny, ale sprawdza przede wszystkim idealny przebieg.
Nie pokazuje, jak rozwiązanie zachowa się wtedy, gdy:
- system docelowy nie odpowiada,
- odpowiedź przychodzi po czasie,
- komunikat pojawia się ponownie,
- brakuje wymaganej wartości,
- wygasły dane autoryzacyjne,
- operacja została wykonana, ale potwierdzenie nie wróciło.
Nie chodzi o stworzenie katalogu wszystkich możliwych awarii.
Trzeba sprawdzić przede wszystkim te sytuacje, których błędna obsługa może zatrzymać proces, zgubić dane albo spowodować wykonanie tej samej czynności więcej niż raz.
Dobrze przeprowadzony test nie powinien więc odpowiadać wyłącznie na pytanie:
„Czy systemy potrafią wymienić dane?”
Powinien również sprawdzić:
czy po zakłóceniu potrafimy ustalić stan procesu i bezpiecznie doprowadzić go do właściwego rezultatu?
Integracja musi zakładać, że system po drugiej stronie będzie się zmieniał
Uruchomienie integracji nie zamyka jej cyklu życia.
System zewnętrzny może zmienić wersję API, sposób uwierzytelnienia, wymagane pole, strukturę odpowiedzi, słownik statusów albo limit wywołań.
Zmiany zachodzą również wewnątrz organizacji.
Pojawiają się nowe typy dokumentów, kolejne kanały sprzedaży, dodatkowe dane i zmienione reguły procesu.
Nie każdą zmianę można przewidzieć.
Można jednak zaprojektować integrację tak, aby było wiadomo, które elementy procesu zależą od konkretnego połączenia, gdzie znajduje się konfiguracja i mapowanie oraz w jaki sposób kontrolować kolejne zmiany.
Integracja nie jest więc jednorazowym zadaniem technicznym. Jest elementem rozwiązania, który również wymaga utrzymania i rozwoju.
Wspólna warstwa integracyjna pomaga uporządkować powtarzalne mechanizmy
W środowisku, w którym działa wiele integracji, powtarzają się podobne potrzeby.
Trzeba konfigurować połączenia, mapować dane, nadawać operacjom statusy, zapisywać wyniki, analizować błędy i obsługiwać nieudane transmisje.
Jeżeli każde połączenie rozwiązuje te problemy oddzielnie, po kilku latach może powstać zbiór mechanizmów działających według innych zasad.
Jednym ze sposobów ograniczenia tego problemu jest wydzielenie wspólnej warstwy integracyjnej.
W środowisku Certusoft taką rolę może pełnić Connector - warstwa porządkująca wymianę danych pomiędzy systemami oraz mechanizmy związane z obsługą i śledzeniem operacji.
Najważniejsza nie jest jednak sama technologia komunikacji.
Wartość wspólnej warstwy polega na tym, że powtarzalne problemy integracyjne mogą być obsługiwane według spójnych zasad.
Dokument przechodzący między ERP, e-commerce, WMS albo systemem partnera nie jest wtedy wyłącznie kolejnym wywołaniem API.
Ma swój przebieg, status, historię i określony sposób reakcji na błąd.
Jak ocenić integrację przed uruchomieniem
Przed odebraniem projektu integracyjnego warto sprawdzić nie tylko, czy systemy potrafią przesłać przykładowe dane.
Pomocnych może być osiem pytań:
-
Czy dla każdego rodzaju danych wiadomo, który system jest źródłem rozstrzygającym?
-
Czy zdefiniowano mapowanie pól, słowników, identyfikatorów i wymaganych wartości?
-
Czy wiadomo, co oznacza timeout i jak ustalamy, czy operacja rzeczywiście została wykonana?
-
Które błędy można ponowić automatycznie, a które wymagają poprawienia danych lub reakcji człowieka?
-
Co chroni proces przed utworzeniem duplikatu podczas ponowienia operacji?
-
Czy pojedynczą transmisję można znaleźć i powiązać z konkretnym dokumentem lub operacją biznesową?
-
Czy po wyczerpaniu automatycznych prób problem pozostaje widoczny i możliwy do dalszej obsługi?
-
Czy monitoring i testy pozwalają wykryć oraz przećwiczyć problemy inne niż tylko poprawny przebieg integracji?
Jeżeli na te pytania nie ma odpowiedzi, działające API może oznaczać dopiero początek pracy nad integracją.
Integracja jest gotowa wtedy, gdy potrafimy kontrolować również wyjątki
Najprostszy scenariusz wymiany danych jest łatwy do pokazania.
System A wysyła informację. System B ją odbiera. Odpowiedź wraca.
W rzeczywistym środowisku jakość integracji ujawnia się jednak przede wszystkim wtedy, gdy ten przebieg zostaje zakłócony.
Pojawia się timeout. Dane są niepoprawne. Komunikat przychodzi drugi raz. System zewnętrzny nie odpowiada. Operacja została wykonana, ale potwierdzenie zaginęło. Zmienia się format danych.
Właśnie dlatego API jest tylko kanałem komunikacji.
O tym, czy integracja wspiera proces biznesowy w sposób kontrolowany, decydują mechanizmy wokół niego: walidacja, obsługa błędów, retry, ochrona przed duplikatami, możliwość ustalenia stanu, logowanie, korelacja, monitoring i dalsze utrzymanie.
Dobra integracja nie powinna obiecywać, że błąd nigdy się wydarzy.
Powinna pozwalać odpowiedzieć na trzy znacznie ważniejsze pytania:
Co się stało?
Jaki jest teraz stan procesu?
Co trzeba zrobić, żeby bezpiecznie go kontynuować?
Sprawdźmy nie tylko, czy systemy są połączone
Jeżeli kluczowy proces w organizacji przechodzi przez kilka systemów, warto sprawdzić nie tylko, czy istnieją między nimi techniczne połączenia.
Równie ważne jest to, co wydarzy się wtedy, gdy jedna z operacji nie przebiegnie zgodnie z planem.
Chcesz sprawdzić, czy kluczowe integracje są przygotowane również na błędy i wyjątki?
Sprawdźmy, czy można je nie tylko uruchomić, ale również monitorować, diagnozować i bezpiecznie odtwarzać wtedy, gdy coś przestaje działać zgodnie z idealnym scenariuszem.
Porozmawiajmy o integracjach i przepływie danych.
FAQ
Czy samo API wystarczy do integracji dwóch systemów?
Nie. API zapewnia sposób komunikacji pomiędzy systemami, ale nie rozwiązuje m.in. interpretacji i walidacji danych, obsługi błędów, ponawiania operacji, ochrony przed duplikatami czy monitoringu. To mechanizmy wokół samego połączenia decydują o tym, jak integracja zachowa się poza idealnym scenariuszem.
Co oznacza timeout w integracji systemów?
Timeout oznacza, że system wysyłający nie otrzymał odpowiedzi w określonym czasie. Nie oznacza jednak automatycznie, że operacja po stronie odbiorcy nie została wykonana. Dokument lub zamówienie mogło zostać zapisane, a problem dotyczyć wyłącznie odpowiedzi. Dlatego przed ponowieniem trzeba uwzględnić ryzyko wykonania tej samej operacji drugi raz.
Czym jest idempotencja w integracji?
Idempotencja pozwala ponowić tę samą operację bez ponownego wywołania jej niepożądanych skutków. W praktyce chroni np. przed utworzeniem drugiego zamówienia, dokumentu lub płatności po powtórzeniu transmisji.


 Skontaktuj się